
Architettura dati aperta per sistemi di IA fisica
NVIDIA, Microsoft Azure e Nebius collaborano per implementare un framework scalabile di data factory per robotica, agenti di IA visiva e sviluppo di veicoli autonomi.
www.nvidia.com
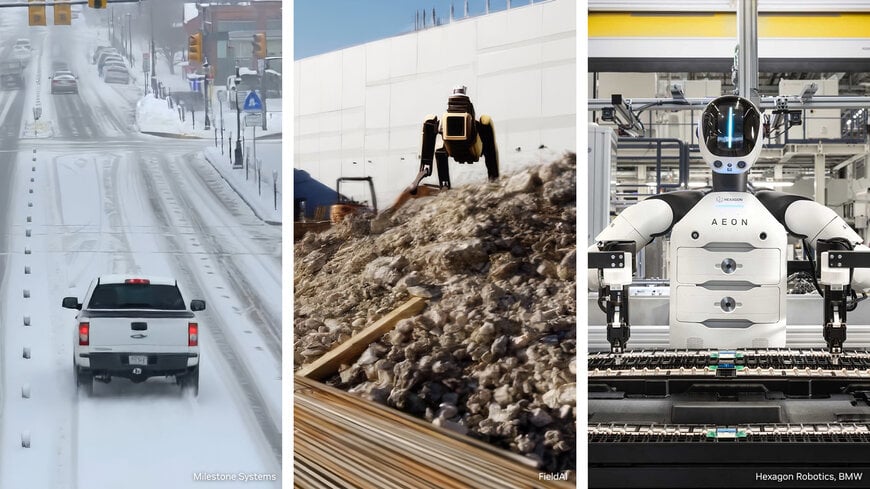
NVIDIA, in collaborazione con Microsoft Azure e Nebius, ha presentato un’architettura di riferimento aperta progettata per industrializzare la generazione e l’elaborazione dei dati per sistemi di IA fisica, inclusi applicazioni nella robotica e nella mobilità autonoma.
Contesto della collaborazione
La collaborazione tra NVIDIA, Microsoft Azure e Nebius affronta una limitazione fondamentale nello sviluppo dell’IA fisica: la disponibilità di grandi quantità di dati di addestramento di alta qualità.
I sistemi di IA fisica, come i veicoli autonomi, le piattaforme robotiche e gli agenti di IA visiva, richiedono dataset diversificati che includano scenari rari e critici per la sicurezza. La raccolta di tali dati nel mondo reale è costosa in termini di risorse e spesso impraticabile. L’obiettivo della collaborazione è sostituire i processi manuali di raccolta dati con flussi di lavoro automatizzati basati sulla capacità computazionale.
Soluzione tecnica e responsabilità
La soluzione si basa sul NVIDIA Physical AI Data Factory Blueprint, un’architettura aperta che organizza le pipeline dei dati in fasi modulari: curazione, augmentazione ed evaluation.
NVIDIA fornisce lo stack software principale, comprese le soluzioni basate su Cosmos per l’elaborazione dei dati, la generazione di dati sintetici e la validazione. Questi componenti permettono di trasformare dataset limitati in corpus di addestramento ampliati utilizzando simulazioni e modelli generativi.
Microsoft Azure integra questa architettura nella propria infrastruttura cloud, combinando servizi come operazioni IoT, piattaforme dati e analisi in tempo reale per supportare flussi di lavoro di machine learning su scala enterprise.
Nebius fornisce l’integrazione a livello infrastrutturale, combinando calcolo accelerato da GPU (sistemi RTX PRO 6000 classe Blackwell), object storage ed esecuzione serverless per il deployment completo delle pipeline.
L’architettura opera tramite flussi di lavoro automatizzati che raffinano i dati grezzi, generano varianti sintetiche (inclusi scenari rari) e validano i risultati attraverso modelli di valutazione basati sul ragionamento. Ciò riduce l’intervento manuale e standardizza la qualità dei dati.
Uno strato di orchestrazione, NVIDIA OSMO, gestisce i carichi di lavoro distribuiti tra diversi ambienti di calcolo. Si integra con agenti di coding AI per automatizzare l’allocazione delle risorse e l’esecuzione delle pipeline, supportando l’automazione industriale dei flussi di dati.
Implementazione e distribuzione
L’architettura è distribuita in ambienti cloud, consentendo agli sviluppatori di configurare pipeline di dati senza dover costruire infrastrutture dedicate.
Su Azure, il sistema è parte di una toolchain aperta per l’IA fisica, permettendo l’integrazione con i sistemi IT aziendali. Nebius implementa l’architettura nella propria AI cloud, supportando pipeline pronte per la produzione con servizi gestiti di inferenza e dati.
I primi utilizzatori, tra cui FieldAI, Hexagon Robotics, Linker Vision e Teradyne Robotics, stanno testando il sistema in ambiti come percezione, mobilità e reinforcement learning. Ulteriori implementazioni sull’infrastruttura Nebius supportano applicazioni di video analytics e robotica.
Applicazioni e casi d’uso
L’architettura si rivolge a diversi settori industriali:
- Sistemi di guida autonoma che richiedono addestramento su scenari rari
- Robotica industriale e di servizio basata su reinforcement learning
- Agenti di IA visiva per sorveglianza e analisi
I casi d’uso includono addestramento basato su simulazione, validazione dei modelli di percezione in condizioni variabili e espansione continua dei dataset per sistemi adattivi.
Risultati e impatto previsto
La collaborazione introduce un passaggio dalla raccolta dei dati alla generazione dei dati, utilizzando risorse computazionali per produrre dataset di addestramento in modo sistematico. Questo approccio riduce la dipendenza dalla raccolta di dati reali e migliora la copertura di scenari rari.
Dal punto di vista operativo, il framework migliora scalabilità, ripetibilità e validazione delle pipeline di addestramento dell’IA. Integrando infrastrutture cloud con flussi di lavoro automatizzati, il sistema consente cicli di iterazione più rapidi e prestazioni più consistenti dei modelli in ambienti complessi.
Modificato dalla giornalista industriale Sucithra Mani con il supporto dell'IA.
www.nvidia.com
Richiedi maggiori informazioni…
